Bạn đã từng ký duyệt một tài liệu thiết kế. Trong đó thế nào cũng có một câu kiểu “khi vượt X thì làm Y”. Có ai từng sinh thử đúng X dòng để xem con số đó có đúng như nó nói không?
Cuối tháng trước, tôi duyệt một thiết kế cho phép tra cứu trên một cột không có index. Bảng chứa cột đó không thuộc team tôi. Tôi viết điều kiện để sửa lại thành một câu có hai con số: “khi bảng vượt khoảng 1.000.000 dòng, hoặc p95 của truy vấn lọc theo voucher vượt 300 ms, thì gửi yêu cầu thêm index non-unique cho team sở hữu.” Câu đó có đúng một nhiệm vụ: đưa phương án “ship mà không thêm index” qua vòng review thiết kế. Nó biến lời hứa “sẽ thêm sau” thành một điều kiện mà người review có thể ký. Và nó đã hoàn thành nhiệm vụ đó.
Tuần này, tôi dựng bench để kiểm hai con số ấy. Vế số dòng lệch 15 lần trên một phiên bản MariaDB, và lệch khoảng 100 lần trên phiên bản kia. Tôi vẫn giữ quyết định hoãn index. Nhưng tôi không giữ được hai con số gắn vào nó. Bài này kể lại tôi đã viết ra hai con số đó như thế nào.
Mổ xẻ: hai con số đến từ đâu
Tính năng rất nhỏ. Người dùng gõ một mã voucher vào ô nhập trên danh sách đơn hàng, và hệ thống tìm những đơn có chứa mã đó. Voucher nằm ở một bảng của hệ thống khác, do team khác bảo trì. Cổng quản trị của chúng tôi chỉ được đọc bảng đó, không được migrate. Bảng có hai loại mã nằm ở hai cột, và cả hai cột đều chưa có index.
Ngưỡng có trước, phép đo có sau. Khi thiết kế đến tay tôi, giai đoạn phân tích đã chốt sẵn hướng đi: ship mà không thêm index, kèm một ngưỡng để đi xin index về sau. Ngưỡng đó là khoảng 1 triệu dòng hoặc p95 300 ms. Việc của tôi là đưa phương án này qua vòng review. Muốn vậy, tôi phải chứng minh hai phương án còn lại tệ hơn, và chứng minh cái ngưỡng kia không phải một lời hứa suông.
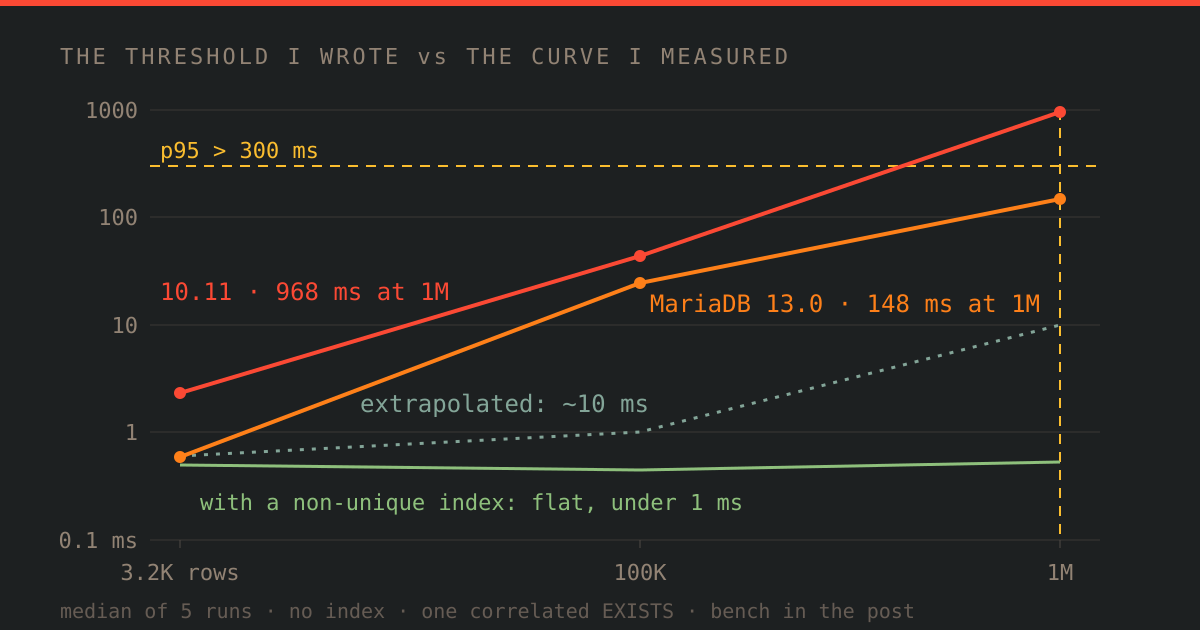
Nên tôi chạy một lần EXPLAIN trên staging. Bảng lúc đó có 3.217 dòng, trung bình 2,14 voucher mỗi đơn, và một lần quét toàn bảng hết chưa tới 1 ms. Từ đúng một điểm đó, tôi kẻ một đường thẳng: khoảng 1 ms ở 100.000 dòng, khoảng 10 ms ở 1.000.000 dòng. Tài liệu thiết kế gọi đường thẳng ấy là “cơ sở” của ngưỡng. Thực tế thì ngược lại. Con số 1 triệu đã nằm sẵn trong biên bản từ trước, và tôi kẻ đường thẳng sau đó để con số có cái mà tựa vào. Tôi không chạy thử ở 100 nghìn dòng. Tôi cũng không chạy thử ở 1 triệu dòng. Con số staging là số đo thật. Đường thẳng kẻ qua nó chỉ là một phỏng đoán, và tôi viết phỏng đoán đó đến hai chữ số thập phân cho có vẻ chính xác.
Vế 300 ms còn không có nổi một phép tính như thế. Biên bản không giải thích vì sao là 300 mà không phải 200 hay 500. Con số nghe hợp lý, và trong biên bản tôi không thấy ai hỏi nó từ đâu ra, kể cả tôi.
Đó cũng là lý do về sau không ai đo lại. Qua vòng review rồi thì con số hết nhiệm vụ, nên không ai quay lại với nó, và không ai lên lịch đo. Chỉ một việc có thể chốt chuyện này: đếm số dòng của bảng đó trên production. Việc ấy đến giờ vẫn treo trong ghi chú bàn giao.
Cùng thiết kế đó còn hai quyết định nhỏ hơn. Một trong hai sẽ quay lại ở cuối bài.
- Mã 10 chữ số trông như một con số, nên cách validate hiển nhiên là coi nó như số. Nhưng tôi đếm trên staging và thấy 9,8% mã bắt đầu bằng số 0. Nếu ép một mã như vậy sang số nguyên, số 0 ở đầu sẽ mất, truy vấn trả về rỗng, và hệ thống không báo lỗi nào. Nghĩa là cứ khoảng mười lần tìm thì một lần “không thấy” mà không ai hay. Vì thế tôi giữ mã voucher là chuỗi từ đầu đến cuối: validate bằng regex, không ép kiểu ở bất kỳ tầng nào, và cột trong file Excel xuất ra khai kiểu text để Excel không tự cắt số 0.
- Hệ thống không biết người dùng gõ loại mã nào, nên truy vấn hiển nhiên là
ORtrên cả hai cột. Nhưng hai định dạng không bao giờ trùng nhau: một loại có đúng 10 chữ số, loại kia có đúng 11 ký tự và luôn chứa chữ cái. Nên tôi gói việc nhận dạng vào một value object. Nó nhận chuỗi thô và trả về đúng một cặp (cột, giá trị), hoặc không trả gì nếu chuỗi không khớp định dạng nào. Cả ba chỗ cần lọc, gồm lưới đơn, lưới đơn phụ và luồng xuất file, đều đi qua value object này. Biên bản ghi một lý do để không dùngOR: không có index thìORbuộc phải quét toàn bảng. Trong đầu tôi còn một lý do thứ hai mà tôi chưa từng viết ra:ORtrên hai cột thì sau này có thêm index cũng khó dùng được.
Đánh đổi (Trade-offs)
Lúc đó có ba phương án, và biên bản còn giữ cả ba.
- Ship không index, viết điều kiện đi xin index thành con số. Tôi chọn phương án này. Nó không lấn sang phần của team khác và không chặn ai. Cái giá là truy vấn sẽ chậm dần theo cỡ bảng, và nếu không ai ghi ngưỡng lại thì ngưỡng sẽ bị quên. Ngưỡng có hai vế nối bằng hoặc: số dòng thì dễ kiểm, còn độ trễ mới là thứ người dùng cảm nhận được.
- Tự thêm index bằng migration trong repo của mình. Tôi loại phương án này. Nó nhanh, nhưng không phải việc của chúng tôi. Chúng tôi không có quyền trên schema đó, và một migration nằm trong repo này sẽ lệch dần khỏi schema của hệ sở hữu.
- Chặn ticket cho đến khi team kia thêm index. Tôi cũng loại. Về lâu dài, đó mới là đích đến đúng. Nhưng làm vậy là bắt một thay đổi ít rủi ro phải chờ backlog của người khác, để đổi lấy một lợi ích mà ở 3.217 dòng tôi còn chưa đo nổi.
Bên trong phương án đầu còn hai lựa chọn nhỏ. Thứ nhất, tôi sẽ xin index non-unique, vì ràng buộc unique có thể làm hỏng chỗ hệ sở hữu ghi mới hoặc ghi lại dữ liệu (insert/retry), mà hệ đó tôi không hiểu đủ để dám phán. Thứ hai, tôi ghi ngưỡng hẳn vào tài liệu thiết kế, thay vì để nó trong trí nhớ ai đó.
Đến giờ tôi vẫn nghĩ phương án đầu là đúng. Thứ tôi muốn làm khác là hai con số gắn vào nó, và thứ tự giữa việc chốt con số với việc đo.
Kết quả đo được
Bench nằm ở bench/khong-them-index-viet-nguong-leo-thang-thanh-so. Nó chạy bằng một lệnh, chỉ cần Docker, và mất chừng hai phút cho mỗi phiên bản.
- Dữ liệu: hai bảng đặt tên chung chung, sinh bằng sequence engine của MariaDB, khoảng 2,14 voucher mỗi đơn.
- Truy vấn: một
EXISTStương quan, đúng dạng truy vấn mà lưới đơn hàng đang dùng. - Cách đo: mỗi biến thể chạy 5 lần, mỗi lần nhắm vào một voucher khác đang có trong bảng. Thời gian đo ngay trên server bằng
SYSDATE(6). Bảng dưới ghi trung vị.
Đơn vị mili giây, theo số dòng của bảng voucher:
| Biến thể | 3.217 | 100.000 | 1.000.000 |
|---|---|---|---|
| MariaDB 13.0.2, không index | 0,589 | 24,797 | 147,656 |
| MariaDB 13.0.2, index non-unique | 0,125 | 0,093 | 0,204 |
MariaDB 13.0.2, OR hai cột, cả hai có index | 0,167 | 0,330 | 0,565 |
| MariaDB 10.11.18, không index | 2,319 | 44,279 | 967,945 |
| MariaDB 10.11.18, index non-unique | 0,426 | 0,503 | 0,622 |
MariaDB 10.11.18, OR hai cột, cả hai có index | 0,561 | 0,523 | 0,454 |
Số đầu tiên làm tôi khựng lại không phải 148 ms, mà là 485. Ở 1 triệu dòng trên 13.0, tôi chạy bốn lượt, mỗi lượt lấy trung vị của 5 lần. Bốn lượt cho ra 148, 485, 162 và 129 ms. Ghi chú kèm lượt 485 cho biết lúc đó một tiến trình khác đang chiếm CPU. Ba lượt còn lại đều nằm trong khoảng 129 đến 162, nên tôi giữ 148. Tiếp theo, tôi kiểm xem truy vấn trong bench có đúng dạng EXISTS mà lưới đơn hàng đang dùng không, hay nó vô tình dễ hơn hoặc khó hơn. Nó đúng dạng. Rồi tôi tính lại: 148 so với 10, 968 so với 10, và từ 100 nghìn lên 1 triệu thì thời gian tăng gấp 22 lần. Đến lúc ấy tôi mới nghĩ tới production. Điều đầu tiên tôi nhận ra là tôi không biết production chạy MariaDB bản nào.
Bảng này có ba chỗ nói ngược với những gì tôi đã viết.
- Ngoại suy sai trên cả hai phiên bản. Con số “dưới 1 ms” ở staging tái lập được trên 13.0 (0,6 ms), nhưng không tái lập trên 10.11 (2,3 ms). Mức tăng không phải 1 ms cho mỗi 100 nghìn dòng. Riêng 100 nghìn dòng đầu đã tốn khoảng 25 ms trên 13.0 và 44 ms trên 10.11. Qua mốc đó, 13.0 tăng chậm hơn tuyến tính, còn 10.11 tăng nhanh hơn cả tuyến tính: từ 100 nghìn lên 1 triệu, số dòng gấp 10 mà thời gian gấp 22. Cái “khoảng 10 ms ở 1 triệu” của tôi ngoài đời là 148 ms trên bản này và 968 ms trên bản kia.
- Hai vế của ngưỡng đá nhau. Trên 13.0 lúc máy rảnh, 1 triệu dòng mất khoảng 130 đến 160 ms qua ba lượt. Vế số dòng chạm ngưỡng trước, còn vế 300 ms gần như thừa. Nhưng lượt chạy lúc CPU bị tiến trình khác chiếm cho ra 485 ms. Cùng bảng, cùng phiên bản, mà giờ vế độ trễ lại chạm trước. Trên 10.11, truy vấn vượt mốc 300 ms ở đâu đó giữa 100 nghìn và 1 triệu dòng. Nếu kéo dài từ điểm 100 nghìn, mốc đó rơi vào khoảng 680 nghìn dòng. Nếu kéo từ điểm 1 triệu, mốc đó rơi vào khoảng 310 nghìn. Bench chưa đo ở khoảng giữa. Dù là con số nào, trên bản đó vế số dòng cũng chạm quá muộn. Chỉ còn vế độ trễ che cho người dùng, mà không ai được giao theo dõi vế đó.
- Lý do ghi trong biên bản để loại
ORvẫn đúng; lý do không ghi thì sai. Không index thì quét toàn bảng, và bench không bác điều đó. Nhưng khi cả hai cột đều có index, optimizer trên cả hai phiên bản đều chọn index-merge union, và truy vấn vẫn dưới 1 ms ở 1 triệu dòng. Value object nhìn định dạng chuỗi để chọn cột vẫn là thiết kế hợp lý, vì một điều kiện trúng một index thì không phải trông chờ optimizer gộp gì cả. Nhưng giả định “sau này khó index” là sai. Nó đã chi phối thiết kế, mà tôi chưa từng viết nó ra ở chỗ người khác có thể chất vấn.
Index non-unique xóa hẳn đà tăng: phẳng trong khoảng 0,1 đến 0,6 ms ở cả ba cỡ bảng, trên cả hai phiên bản. Bench không cho thấy index làm gì chậm đi, nhưng bench cũng không đo thao tác ghi. Index này làm chỗ ghi dữ liệu của hệ sở hữu tốn thêm bao nhiêu, tôi vẫn chưa nhìn thấy được.
Giới hạn, và điều tôi sẽ làm khác
- Số dòng trên production vẫn chưa đo. Từ môi trường của tôi, tôi không có cách nào truy vấn bảng đó trên production. Nếu bảng đã gần 1 triệu dòng, mọi thứ viết phía trên vô nghĩa ngay từ ngày phát hành. Việc này treo y nguyên như một tháng trước. Lẽ ra tôi phải đẩy nó lên hỏi team kia đầu tiên, chứ không phải cuối cùng.
- Tôi không biết production chạy MariaDB bản nào. Tôi không thấy chỗ nào trong repo của cổng quản trị pin phiên bản MariaDB, và database không nằm trong Docker của ứng dụng. Bảng trên có hai phiên bản chính vì kết quả ở 1 triệu dòng lệch nhau 6,5 lần. Tôi không nói được dòng nào trong hai dòng ấy là dòng của production.
- Mọi con số trong bảng đều là quét trong bộ nhớ, trên một laptop đang rảnh. Một triệu dòng của schema này vừa lọt trong buffer pool mặc định. Bảng production mà không vừa thì chậm hơn mọi con số ở đây. Bench cũng chạy từng truy vấn một, nên p95 của nó không phải p95 của hệ thống đang chịu tải. Lượt 485 ms ở trên cho thấy máy bận làm con số không index xê dịch tới đâu.
- Luồng xuất file chưa được bench. Nó áp cùng điều kiện lọc cho từng lô, nên chi phí của nó là con số này nhân với số lô.
- Các số staging (3.217 dòng, 9,8% số 0 đầu, 2,14 voucher mỗi đơn) lấy từ một codebase riêng. Bạn không chạy lại được, nên cứ trừ hao khi đọc. Bench mới là phần bạn kiểm được.
Những gì tôi sẽ làm khác đều nhỏ và cụ thể. Lần sau viết ngưỡng bằng số dòng, tôi sẽ sinh đủ chừng ấy dòng trước rồi mới viết. Bench để làm việc đó chỉ gồm một file SQL với một script, mất hai phút mỗi phiên bản, và ngoài Docker không cần gì thêm. Con số nào tôi lấy lại từ tài liệu trước chứ không tự đo, tôi sẽ ghi rõ là lấy lại, thay vì kẻ sau một đường thẳng để hợp thức hóa nó. Con số nào không có xuất xứ, như 300 ms, tôi sẽ đánh dấu là số tạm cho đến khi có người đo. Tôi cũng sẽ viết vế độ trễ trước, vế số dòng sau, vì số dòng là vế tôi chắc nhất, mà hóa ra lại là vế phụ thuộc vào phiên bản. Và tôi sẽ viết ra mọi lý do mà thiết kế dựa vào, kể cả những lý do nghe hiển nhiên đến mức không ai buồn ghi, để sau này người không tham gia lúc đó vẫn kiểm lại được từng lý do.
Câu có hai con số vẫn tốt hơn câu “sẽ thêm index sau”. Chỉ có điều tôi không ngoại suy để đi tìm câu trả lời. Tôi ngoại suy để bảo vệ một con số đã chốt từ trước.