Bạn có một benchmark nói rằng chỗ này chậm. Bạn cũng có sẵn lời giải thích vì sao, và nó nghe rất hợp lý. Nếu bạn đã kịp viết lời giải thích đó vào tài liệu thiết kế hay vào ticket, thì bài này kể về một bước kiểm tra tôi đã bỏ qua ngay trước khi làm y như vậy, và cái giá của nó.
Hệ thống trong bài là minidb, một database quan hệ nhỏ tôi tự viết bằng Go để học về tầng lưu trữ. Sai lầm trong bài xảy ra được với bất kỳ benchmark nào có hai dòng số.
Câu hỏi
minidb giữ mọi phiên bản (version) của một hàng trong cùng một record, bản mới nhất xếp trước. Một reader mở lâu khiến các bản cũ không được dọn, chuỗi dài ra, và mọi lần đọc khoá đó đều phải đi qua chuỗi ấy. Ngày 02/09/2026 tôi đo:
| độ sâu chuỗi | reader | ns mỗi lần đọc |
|---|---|---|
| 1 | snapshot mới | 171 |
| 60 | snapshot mới | 1450 |
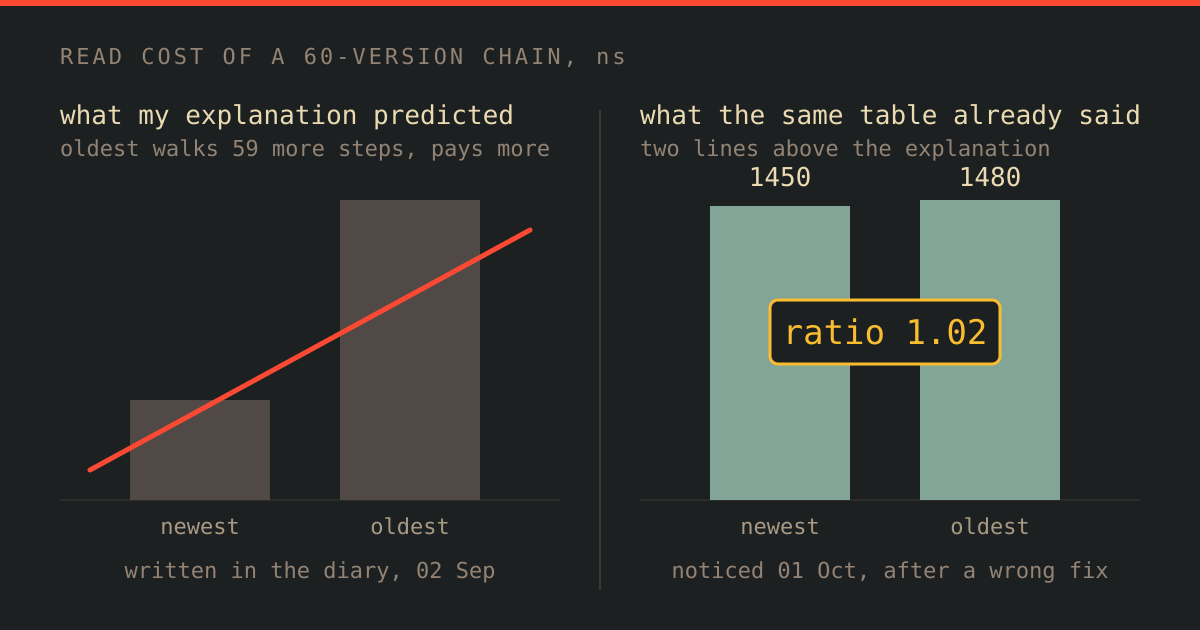
| 60 | snapshot cũ | 1480 |
Độ sâu 60 chậm gấp 8,5 lần độ sâu 1. Câu hỏi có quyết định đi kèm là: 8,5 lần đó đến từ đâu, để sửa đúng chỗ? Có hai khả năng:
- Đi dọc chuỗi và giải mã nó. Nếu vậy, reader cần bản cuối chuỗi phải trả giá cao hơn hẳn reader chỉ cần bản đầu.
- Một việc gì đó làm một lần cho mỗi lần đọc, bất kể cần bản nào. Nếu vậy, hai reader trả giá bằng nhau.
Nhìn lại bảng. oldest / newest = 1480 / 1450 = 1,02. (Nhật ký ghi tỉ số này là 0,98, tức chia ngược chiều; chiều nào thì hai reader cũng tốn như nhau.) Dữ liệu đã trả lời xong câu hỏi. Tôi đã không đọc nó theo cách đó.
Tôi đã tin điều gì, và tin trong bao lâu
Lời giải thích của tôi hôm 02/09: hàm giải mã dựng cả chuỗi thành một mảng trước khi ai kịp hỏi cần bản nào, nên reader nào cũng trả đủ giá cho 60 bản. Cách chữa sẽ là giải mã lười, chỉ dựng đúng bản cần. Ghi điều đó vào nhật ký dự án như nguyên nhân đã xác định, rồi ngày 29/09 lặp lại nó trong một bài blog về transaction mở quá lâu.
Công bằng mà nói, tôi cũng ghi kèm một dự báo ngay bên dưới:
Sau khi sửa,
newestở độ sâu 60 phải tụt về gầnnewestở độ sâu 1, cònoldestgiữ nguyên. Nếu cả hai cùng giảm thì benchmark đang đo cái khác.
Dự báo đó là phần duy nhất trong mục nhật ký hôm ấy còn có giá trị. Nó cũng mâu thuẫn với tỉ số 1,02 nằm hai dòng phía trên, mà suốt bốn tuần không ai nhận ra, kể cả người viết.
Phương pháp đo
Mọi số bên dưới đến từ hai benchmark Go trong repo công khai, cộng một bộ chạy A/B theo cặp ở bench/cho-cham-khong-nam-o-cho-ban-doan-cap-phat-khong-phai-giai-ma. Bộ này clone repo ở ba commit: trước khi sửa, sau lần sửa 1, sau lần sửa 2.
BenchmarkGetChainDepth: một khoá có 1 hoặc 60 phiên bản, đọc bằng snapshot mới và bằng snapshot cũ hơn cả chuỗi. 200.000 đến 300.000 vòng, có đếm cấp phát.BenchmarkCopyVsAlloc: chép 897 byte vào buffer có sẵn, so với cấp phát một slice 1 KB mới rồi chép. Năm lần chạy trong lần tái hiện sạch; lượt của tôi ngày 01/10 không ghi lại số lần chạy.- Chạy theo cặp. Máy đo là laptop chạy WSL2, có hai tiến trình nền ăn gần bốn nhân. Số đơn lẻ nhảy vài chục phần trăm giữa hai lần chạy cách nhau vài phút. Nên bản trước và bản sau được chạy xen kẽ, 10 cặp, và tôi báo trung vị cùng tứ phân vị của tỉ số từng cặp. Nếu khoảng tứ phân vị vắt qua 1,0 thì kết quả là “chưa thấy khác biệt”.
./run.sh 10 # Go 1.26+, git, không cần Docker, khoảng 1,5 phút; in tỉ số từng cặp ở cuối
Số liệu thô
Lần sửa 1, ngày 01/10: giải mã lười, đúng cách chữa đã ghi trong nhật ký. Một hàm mới đọc thẳng trên byte thô của chuỗi, không dựng mảng nào.
| độ sâu 60 | newest | oldest |
|---|---|---|
| sau lần sửa 1 | 2125–2211 ns | 2355–2640 ns |
Số tuyệt đối cao hơn vì hôm đó máy bận hơn. Hai cột đo trong cùng một lượt nên so với nhau vẫn được. Và chúng vẫn bằng nhau. Tôi gỡ đúng thủ phạm theo giả thuyết, nhưng khoảng cách đáng ra phải mở ra thì không mở. (Lần chạy lại sạch trong thư mục bench gắn số cho lần sửa 1: cả hai reader nhanh lên khoảng một phần tư, 0,77 và 0,75, byte cấp phát mỗi lần đọc giảm từ 3585 xuống 897. Trước bằng nhau, sau vẫn bằng nhau.)
Profile của depth=60/newest, cùng ngày:
BenchmarkGetChainDepth/depth=60/newest   300000   5520 ns/op   897 B/op   2 allocs/op

     1.50s  txn.(*Txn).Get
     0.84s    txn.VisibleRaw              56%
     0.43s      txn.(*chainReader).next
     0.64s    db.(*DB).Get                43%
     0.51s      runtime.memmove
Một dòng đáng ngờ. memmove bị tính 0,51 giây cho 300.000 lần chép 897 byte, tức 1,7 µs mỗi lần. Với băng thông bộ nhớ hiện nay, chép 900 byte chỉ mất vài chục nano giây. Nên tôi đo tách hai thứ mà profiler đã gộp làm một:
| ns/op | allocs/op | |
|---|---|---|
| chép 897 B vào buffer có sẵn | 18–25 | 0 |
make 1 KB rồi chép | 890–1865 | 1 |
Lần sửa 2, sau khi có profile. Hai thay đổi:
- Cây B+Tree cho người gọi nhìn thẳng vào page trong lúc page còn bị ghim (pin), tức còn được giữ trong buffer pool, chưa thể bị đuổi ra. Nó không chép cả value ra ngoài nữa.
- Bộ duyệt chuỗi chỉ đọc ba trường header cho mỗi bản. Nó không dựng struct phiên bản đầy đủ cho từng bản trong 60 bản nữa.
| trước | sau | sau/trước, trung vị [Q1, Q3] | |
|---|---|---|---|
| độ sâu 1, newest | 348 ns | 299 ns | 0,85 [0,80; 0,88] |
| độ sâu 60, newest | 5213 ns | 708 ns | 0,14 [0,13; 0,16] |
| độ sâu 60, oldest | 3878 ns | 714 ns | 0,18 [0,17; 0,19] |
| byte cấp phát mỗi lần đọc, độ sâu 60 | 3585 | 4 |
Cột “trước” là code của ngày 02/09 được build lại và chạy ngày 01/10 trên chính cái máy đang bận ấy. Vì thế độ sâu 1 ở đây là 348 ns, còn ở bảng đầu bài là 171 ns. Chỉ tỉ số trong từng cặp mới so được với nhau. Riêng hàng byte cấp phát lấy từ lần chạy lại sạch trong thư mục bench, không lấy từ nhật ký: nhật ký ghi nhầm 897 cho cột “trước”, trong khi 897 là số sau lần sửa 1. Con số 3585 byte xấp xỉ bản chép cả chuỗi cộng với mảng đã giải mã, được bộ cấp phát làm tròn lên theo cỡ khối.
Diễn giải
Profile có hai khoản, và không khoản nào là “tìm bản nhìn thấy được”:
- 43% ở bước tra cây, gần hết là
memmove. Cây trả value bằng cách cấp phát một slice mới rồi chép nguyên chuỗi 897 byte vào đó. Nó buộc phải chép, vì byte nằm trong page có thể thành của page khác ngay khi buffer pool đuổi page đi. Người gọi chỉ cần 3 byte trong số đó (value trong benchmark là chuỗi ba ký tự kiểuv59). - 56% ở bộ duyệt chuỗi. Soi từng dòng của nó bằng
pprof -list: 490 trên 640 ms rơi vào đúng một dòngreturn v, nil. Bộ duyệt dựng một struct phiên bản đầy đủ cho từng bản trong 60 bản, chỉ để vòng lặp bên ngoài đọc một trường rồi vứt đi.
Cả hai khoản đều tăng theo độ sâu. Cả hai đều phải trả ở mọi lần đọc, dù snapshot cần bản đầu hay bản cuối. Đó là lý do newest và oldest bằng nhau hôm 02/09, bằng nhau sau lần sửa 1, và bằng nhau ở cả ba commit trong lần chạy lại sạch.
Con số “chép mất 1,7 µs” thật ra là một lần cấp phát. Profiler tính chi phí cho kẻ chạm vào vùng nhớ mới đầu tiên, và kẻ đó là memmove. Một benchmark năm dòng tách được hai thứ profiler đã dính làm một.
Đọc lại dự báo: cả hai reader cùng giảm, 5 đến 7 lần. Theo đúng luật tôi tự đặt, benchmark đang đo cái khác. Nhưng benchmark không sai. Sai là mô hình trong đầu: tôi tưởng chi phí nằm ở việc đọc hiểu chuỗi, trong khi nó nằm ở việc bê chuỗi ra và dựng struct cho nó.
Độ sâu 60 vẫn đắt hơn độ sâu 1 khoảng 2,4 lần. Phần còn lại đó tôi quy cho bước đi hết chuỗi để kiểm đuôi, bước mà tôi cố ý giữ: một chuỗi hỏng ở đuôi phải báo lỗi ngay ở lần đọc đầu tiên chạm vào nó, chứ không nằm im chờ một reader cũ. Một fuzz test đối chiếu bộ duyệt chuỗi mới với bản cũ ở mọi snapshot; khi tôi cố tình cài lỗi “dừng sớm”, nó bắt được sau 0,08 giây.
Đánh đổi (Trade-offs)
- Cho nhìn thẳng vào dữ liệu có sẵn (view) thay vì chép ra là một ràng buộc về vòng đời: slice chỉ dùng được bên trong callback, lúc page còn bị ghim. Giữ lâu hơn là đọc phải byte của page khác, và không có lỗi nào báo. API cũ chậm nhưng an toàn; API mới nhanh và có một luật bạn có thể phá mà không ai biết.
- Giữ bước kiểm đuôi tốn 2,4 lần trên chuỗi sâu. Bỏ đi thì đọc nhanh hơn và phát hiện hỏng muộn hơn. Tôi chọn phát hiện sớm.
- Chạy theo cặp tốn gấp đôi thời gian so với so hai số rời. Trên máy yên tĩnh thì không cần; trên máy này, nó là khác biệt giữa một con số và một phỏng đoán.
Giới hạn của phép đo
- Chi phí cấp phát là tính chất của kernel, không phải của code. Trên WSL2, cấp phát rồi chép mất 890–1865 ns, gấp khoảng 50 lần phép chép, và tắt page fault đi vẫn còn khoảng 550 ns. Trên Linux thuần (Ryzen 7 H 255, cùng ngày) chỉ 154–193 ns, gấp khoảng 7 lần. Kết luận định tính giữ được; độ lớn thì không. Hãy trích tỉ số, đừng trích nano giây.
- Không có đĩa, một goroutine. Mọi thứ nằm gọn trong buffer pool. Tranh chấp ghim page chưa được thử.
- Mới tái hiện một lần, trong container, trên cùng một kiểu máy.
run.shchạy trong imagegolang:1.26sạch trên máy WSL2, 10 cặp. Trước khi sửa,oldest / newest= 1,03. Sau khi sửa, cả hai reader còn 0,21 so với trước, và độ sâu 60 vẫn gấp 2,2 lần độ sâu 1. Cùng phát hiện, tỉ số dịu hơn 0,14 / 0,18 của tôi. Vẫn chưa có số đo trên Linux thuần. - Điều kiện làm kết luận đảo chiều: một cách bố trí mà bản cũ nằm chỗ khác (undo log, page riêng) sẽ xoá khoản “chép cả chuỗi” ngay từ thiết kế. Khi đó phần chi phí theo độ sâu còn lại mới thật sự là đi theo con trỏ, và lời giải thích hôm 02/09 sẽ đúng cho hệ đó. Nó sai cho hệ này.
Tôi làm khác đi thế nào
Dự báo đã cứu tôi, nhưng muộn một tháng. Thứ có thể cứu tôi sớm hơn còn rẻ hơn nhiều: trước khi ghi một nguyên nhân vào nhật ký, kiểm xem các con số đã có trong bảng có đồng ý với nó không. Tỉ số 1,02 giữa hai reader mà câu chuyện của tôi nói phải khác nhau không phải chi tiết tinh vi. Nó là câu trả lời, và nằm ngay một dòng phía trên câu trả lời sai của tôi.
Tôi giải thích một con số bằng câu chuyện nghe hợp lý rồi ghi câu chuyện đó thành sự thật, trong khi tỉ số bác nó đã nằm ngay cạnh từ đầu.