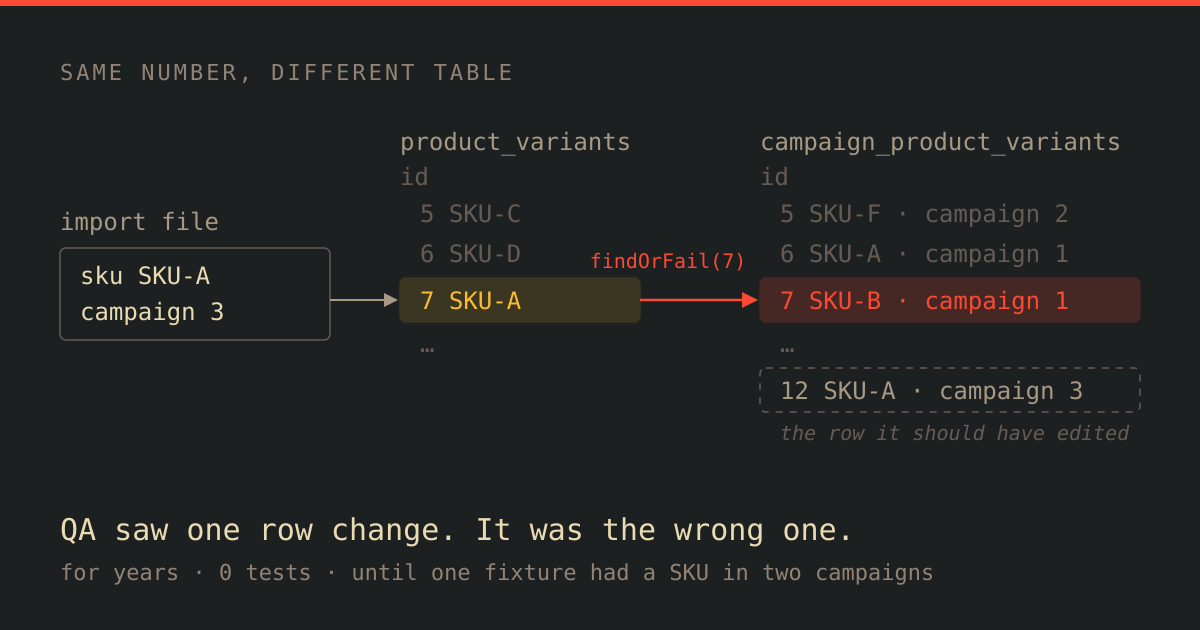
Tính năng import điều chỉnh quota chương trình khuyến mãi từ file bảng tính đã chạy trên production nhiều năm. Lần kiểm thử thủ công nào cũng giống nhau: tải một file lên, mở chương trình ra, thấy một quota đã đổi, đóng ticket. Handler này không có một test tự động nào.
Nó đang sửa nhầm dòng. Không phải thỉnh thoảng, mà về cấu trúc: lần chạy nào mà hai id trùng nhau thì lần đó sửa sai, và trên staging thì chúng trùng thật. Trong những năm đó nó đã đụng vào bao nhiêu dòng trên production, tôi chưa đo và sẽ không đoán ở đây. Thứ tôi chỉ ra được là cơ chế, vì sao ba lớp bảo vệ khác nhau đều để nó đi qua, và một test duy nhất mà nếu có từ ngày đầu thì đã bắt được.
Mổ xẻ: một id mang một nghĩa trong file và một nghĩa khác trong code
File import có một cột mã hàng (SKU). Handler đổi mã đó thành sku_id, tức khóa chính của bảng product_variants, bảng chứa các SKU đang bán. Rồi nó gọi find-or-fail của ORM trên model quota với đúng id đó, tức là câu SQL này (dựng lại trong bench, không chép từ codebase):
SELECT * FROM campaign_product_variants WHERE id = :sku_id
Model quota lại là một bảng khác: campaign_product_variants, mỗi dòng là một cặp (chương trình, SKU) kèm quota của cặp đó. Khóa chính của nó không liên quan gì đến khóa chính của SKU. Code cầm một product_variants.id rồi đem tra như thể nó là campaign_product_variants.id.
Vậy sao nó vẫn chạy được? Cả hai bảng đều dùng auto-increment bắt đầu từ số nhỏ. Trên một database staging mà hai bảng cùng được đổ dữ liệu từ dưới lên, một id như 7 có mặt ở cả hai bên. findOrFail tìm thấy một dòng, lệnh cập nhật thành công, và một quota đổi giá trị. Đó đúng là thứ QA đang kiểm.
Giả sử file ghi: SKU-A, có product_variants.id là 7, cần đặt quota thành 50 trong chương trình 3. Handler tải dòng số 7 của campaign_product_variants. Dòng đó lại thuộc SKU-B, chương trình 1. Quota của SKU-B bị đặt thành 50. Mở chương trình 3: SKU-A không đổi gì. Mở chương trình 1: SKU-B giờ là 50. Không ai mở chương trình 1, vì ticket nói về chương trình 3.
Ba lớp bảo vệ, ba lỗ hổng riêng rẽ:
- Test: handler này không có test nào. Bằng không. Nhưng kể cả một test viết theo cách tự nhiên nhất, tức là tạo một SKU, tạo một dòng chương trình, chạy import, rồi kiểm kết quả, cũng sẽ xanh, vì cả hai fixture đều nhận id 1.
- Code review: dòng code đó đọc lên thấy đúng. Biến tên là
sku_id, tên model cũng có chữ “product variant”, và find-or-fail trên một model là kiểu viết ORM quen tay. Chỗ lệch nằm ở nghĩa chứ không nằm ở cú pháp, và không có gì trên màn hình nói rằng hai id này thuộc hai dãy số khác nhau. - QA thủ công: câu hỏi kiểm là “có một dòng đổi không?”, và lần nào cũng có một dòng đổi. Câu hỏi bắt được lỗi phải là “dòng đúng có đổi không, và có dòng nào khác bị đụng không?”. Muốn hỏi được câu đó thì fixture phải có chương trình thứ hai, mà kịch bản QA đi theo luồng chính thì không dựng thứ đó.
Lỗi chỉ lộ ra khi có một tiêu chí chấp nhận (acceptance criterion) mới. Tiêu chí đó không nói gì về phép tra cả: hệ thống sắp có một chế độ tồn kho mới, SKU bán theo kho chung thay vì quota riêng từng chương trình, và import phải từ chối mọi dòng trỏ vào SKU đang ở chế độ đó. Muốn biết một dòng có ở chế độ đó không thì phải tải đúng dòng. Đọc lại handler để làm việc ấy là lúc cách tra bằng một id đơn kia không còn trông vô hại nữa.
Đánh đổi (Trade-offs)
Import có hai bước cùng tra một dòng: bước kiểm tra (validate) quyết định dòng đó có hợp lệ không, và bước xử lý (process) ghi quota xuống. Tiêu chí chấp nhận chỉ đòi từ chối dòng, mà từ chối thì xảy ra ở bước kiểm tra. Có ba phương án được đặt lên bàn, và biên bản quyết định giữ lại cả ba.
- Tra theo cặp chỉ ở bước kiểm tra, giữ nguyên bước xử lý. Loại. Đây là phương án “làm vừa đủ cho tiêu chí xanh”, và nó đáp ứng tiêu chí đúng từng chữ: bước kiểm tra sẽ nhận diện đúng dòng (SKU, chương trình), báo cáo về nó, rồi bước xử lý vẫn ghi vào nhầm dòng y như cũ. Một bước kiểm tra canh một dòng trong khi bước ghi đụng dòng khác thì còn tệ hơn không kiểm, vì nó cho ra báo cáo xanh cho một lần ghi sai.
- Tra theo cặp ở cả hai bước. Chọn. Handler giờ đổi mã SKU thành
product_variants.id, rồi tìm dòng chương trình theo(product_variant_id, campaign_id)qua danh sách sản phẩm của chương trình, ở bước kiểm tra lẫn bước xử lý. Mỗi dòng file tốn nhiều lượt tra hơn trước. Tôi chưa đo thời gian chạy import trước và sau, nên sẽ không khẳng định phần chênh là không đáng kể. - Tách bản sửa ra ticket riêng, chặn tiêu chí chấp nhận lại chờ nó. Loại. Biên bản ghi hai lý do: tiêu chí không thể làm được khi phép tra còn sai, và phạm vi đợt phát hành đã khóa nên không dời được. Tôi thêm một lý do thứ ba mà biên bản không ghi: trong lúc chờ, import vẫn ghi sai quota.
Quyết định thứ hai là về test, và đây là quyết định tôi sẽ bảo vệ mạnh nhất. Một test hồi quy tạo một SKU trong một chương trình rồi kiểm dòng tra được là đúng thì sẽ xanh ngay trên code hỏng: mỗi bảng một dòng thì id trùng nhau. Test tôi viết thay vào đó đặt một SKU vào hai chương trình, điều chỉnh chương trình B, rồi kiểm hai điều:
- Dòng tra được là dòng của B, không phải dòng của A.
- Id của dòng đó không phải id của SKU.
Cái giá là phải dựng thêm chương trình thứ hai: nhiều fixture hơn một test đi luồng chính cần, và một test đọc lên ít giống câu chuyện mà giống cái bẫy hơn. Test này chỉ kiểm bước tra; nó không chạy bước ghi rồi kiểm quota của chương trình A đứng yên. Đó là một lỗ hổng, và tôi nêu tên nó ở mục dưới.
Kết quả đo được
| Chỉ số | Trước | Sau |
|---|---|---|
| Test tự động trên handler import | 0 | 1 |
| Test đỏ trên code gốc | 0 | 1 |
Bảng chỉ có thế, và tôi không độn thêm. Con số đến từ codebase riêng tư, bạn không kiểm chứng lại được. Số dòng dữ liệu sai trước và sau thì không tồn tại, vì tôi không chạy rà soát trên production. Bản sửa ra cùng với tiêu chí chấp nhận mới; rà lại dữ liệu cũ không nằm trong phạm vi đó.
Còn cơ chế thì bạn chạy lại được. bench/bug-import-tra-nham-bang dựng lại từ đầu với tên bảng tự đặt, không có dòng code công ty nào: hai bảng cùng auto-increment, một import tra nhầm bảng, và hai test đặt cạnh nhau. Test thứ nhất tạo một SKU trong một chương trình và xanh trên code hỏng. Test thứ hai tạo một SKU trong hai chương trình, đỏ trên code hỏng, xanh trên bản sửa. Một lệnh chạy cả hai.
Giới hạn, và điều tôi sẽ làm khác
Bài này không nói được: production đã sai bao nhiêu dữ liệu, id trên production có trùng nhau như staging không, và có người vận hành nào từng thấy một quota mình không đặt hay không. Tôi không đo thứ nào trong đó, và bench cũng không đo được: nó dựng lại cơ chế, không dựng lại phạm vi thiệt hại. Test hồi quy cũng dừng ở bước tra: chưa có gì kiểm rằng sau một lần ghi thật vào chương trình B, quota của chương trình A vẫn nguyên.
Quy tắc chung tôi rút ra: mọi handler dạng “lấy id từ thực thể X, tra sang thực thể Y” đều cần một test mà X và Y cố tình có id khác nhau. Test dùng id trùng thì xanh dù code đúng hay sai, thế còn tệ hơn không có test: nó tạo ra sự yên tâm mà không có bằng chứng nào phía sau.
Điều tôi sẽ làm khác: tôi sẽ không chờ một tiêu chí chấp nhận buộc mình đọc lại handler. Bất kỳ luồng import nào có bằng không test và nhiều năm QA xanh đều là chỗ mà “không có gì sai” và “không có gì được kiểm” đã trở thành không phân biệt được. Lần tới nhận một luồng như thế, tôi sẽ viết test hai chương trình trước khi đụng vào bất cứ thứ gì khác, và để nó nói cho tôi biết những năm im ắng kia có lý do chính đáng hay không.