Trên dashboard giám sát của bạn chắc có một biểu đồ vẽ từ bộ đếm trạng thái (status counter) mà bạn chọn vì cái tên của nó. Có khi câu truy vấn được chép từ dashboard của một database khác, hoặc của một nhánh khác cùng họ. Đã bao giờ bạn lấy mẫu tay bộ đếm đó, đặt cạnh một bộ đếm mình đã hiểu rõ, để xem hai thứ có tăng như mình nghĩ không?
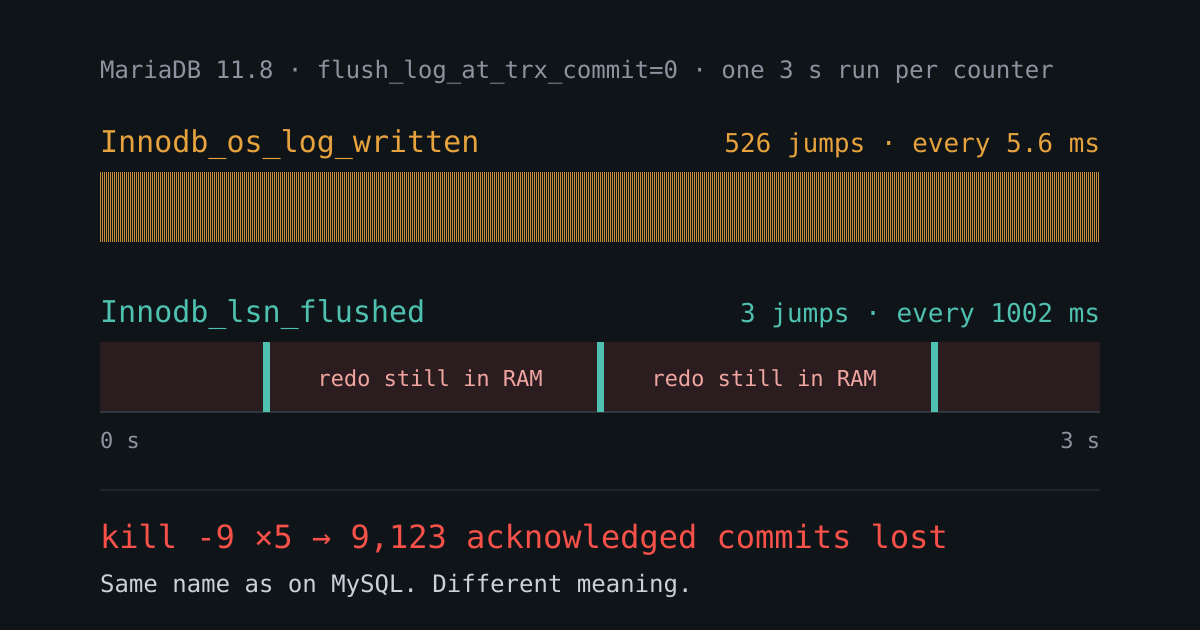
Tôi chọn Innodb_os_log_written cho một phép đo, vì tên của nó nói đúng thứ tôi cần: số byte redo log đã ghi. Trên MySQL 8.4, bộ đếm này khớp với kết quả crash test. Trên MariaDB 11.8, nó báo redo log rời khỏi tiến trình cứ 5,6 ms một lần. Thế nhưng trước đó cùng ngày, một bài crash test trên chính server đó đã làm mất 9.123 commit đã báo thành công. Muốn mất nhiều như vậy thì log phải nằm trong RAM gần trọn một giây. Cả hai con số đều do tôi tự đo, và chúng không thể cùng đúng.
Câu hỏi
Đặt innodb_flush_log_at_trx_commit = 0 thì commit trả về ngay, không chờ redo log. Tài liệu của MySQL viết rằng nếu log được flush mỗi giây một lần thì có thể mất tới một giây transaction khi crash. Bài crash test của tôi (kill -9, năm vòng mỗi chế độ) lại cho kết quả khác xa:
chế độ                                      đã báo OK    mất
MariaDB 11.8, flush_log_at_trx_commit=0         43427   9123
MySQL 8.4,    =0 + sync_binlog=0                24339      6
Cùng họ engine, cùng giá trị biến. Tính theo tỉ lệ trên số commit đã báo OK thì là 21% so với 0,025%, chênh nhau khoảng 850 lần. Hai số lấy từ hai lượt chạy riêng, nên chỉ nên đọc nó như một bậc độ lớn.
Muốn hiểu vì sao thì phải theo một byte redo đi qua ba chặng trước khi nó an toàn:
- Log buffer: RAM bên trong tiến trình database.
- Page cache của OS: tới được bằng
write(). Tiến trình chết thì phần này vẫn còn. - Đĩa: tới được bằng
fsync(). Cả máy chết thì phần này vẫn còn.
kill -9 chỉ xóa chặng đầu. Vậy mỗi lần kill mất bao nhiêu commit chỉ phụ thuộc vào một điều: từ lần write() gần nhất tới lúc chết là bao lâu. Câu hỏi thành ra: ở chế độ =0, mỗi server gọi write() lên redo log thưa hay dày đến đâu?
Phương pháp đo
- Môi trường: MySQL 8.4 và MariaDB 11.8 chạy Docker trên WSL2, chip i5-1235U. MySQL bật
innodb_flush_method=fsyncvàinnodb_use_native_aio=0. Thời gian tuyệt đối trên máy này nhiễu, nên chỉ tin tỉ số giữa các chế độ. - Tải: một kết nối chèn liên tục, mỗi câu một commit, mỗi chế độ chạy 3 giây.
- Đầu dò: một kết nối khác đọc bộ đếm redo mỗi 5 ms và ghi lại mỗi lần nó nhảy. Khoảng cách giữa hai lần nhảy chính là cửa sổ mất dữ liệu. 5 ms là sàn: thứ gì dày hơn thế cũng chỉ hiện ra khoảng 6 ms.
- Dự báo: số commit mất mỗi lần kill =
rate × Σg² / (2·Σg). Lần kill rơi vào một khoảng dài g với xác suất tỉ lệ với g, và trung bình mất số commit của nửa khoảng đó (rate × g/2). - Kiểm chứng: ghi 1-3 giây rồi kill -9, năm vòng mỗi chế độ, khởi động lại, đếm những id đã báo OK mà không còn trong bảng.
Các số bên dưới lấy từ những lượt chạy gốc, ghi trong diary/phase9.md (bảng 6 và 7), code nằm ở reallab/. Bản chạy lại độc lập, chỉ cần Docker, nằm ở bench/bo-dem-cung-ten-khac-nghia-mariadb-dem-ca-buffer. Nó tái hiện được phát hiện về bộ đếm, và khoảng cách giữa MySQL có luồng ghi (mất vài commit) với hai chế độ còn lại (mất hàng nghìn). Số cụ thể, và chế độ nào trong hai chế độ sau mất nhiều hơn, thì đổi theo từng lần chạy:
./run.sh lograte      # đọc bộ đếm mỗi 5 ms, 3 giây mỗi chế độ
./run.sh crash 5      # kill -9, 5 vòng mỗi chế độ
Số liệu thô
Lượt đầu, đọc Innodb_os_log_written trên cả hai server:
db      chế độ                                    commit/s  số nhảy  khoảng p50  khoảng max
mysql   =0 + sync_binlog=0                            4077      514       5.8ms       7.2ms
mysql   =0 + sync_binlog=0 + log_writer=OFF           4194        8     172.8ms     826.9ms
maria   flush_log_at_trx_commit=0                     4366      526       5.6ms       7.4ms
MySQL ra đúng như dự đoán. MariaDB cũng hiện ra cứ 5,6 ms ghi một lần, tức đúng mâu thuẫn đã kể ở đầu bài. Thứ nên nghi đầu tiên là đầu dò, nên tôi lấy mẫu tay trong lúc MariaDB đang nhận ghi:
lsn_current 3602546893  lsn_flushed 3601694282  os_log_written 3789950  t=38.077
lsn_current 3603397116  lsn_flushed 3601694282  os_log_written 4640173  t=38.495
lsn_current 3604430049  lsn_flushed 3603725140  os_log_written 5673106  t=38.897
Giữa hai mẫu đầu, os_log_written tăng 850.223 byte. lsn_current là vị trí cuối của log, tính cả phần còn trong RAM, và nó cũng tăng đúng 850.223 byte, không lệch byte nào. Còn lsn_flushed thì đứng yên suốt 0,418 giây ấy, tới mẫu thứ ba mới tăng. Vậy trên MariaDB 11.8, bộ đếm này đếm redo được sinh ra, không phải redo đã ghi.
Làm cùng phép so trên MySQL thì hai bộ đếm không khớp nhau. Trong lượt chạy lại độc lập (bench đã dẫn ở trên; 3 giây, bật luồng ghi), chúng tăng hai lượng khác nhau:
mysql   os_log_written   delta 2850816 bytes
mysql   lsn_current      delta 1522191 bytes
Vậy trên MySQL, bộ đếm này không đếm LSN. Còn nó đếm đúng cái gì thì mục giới hạn bên dưới vẫn để ngỏ.
Lượt hai và ba. MariaDB đổi sang đọc Innodb_lsn_flushed, còn MySQL vẫn đọc Innodb_os_log_written:
db      chế độ                                    commit/s  số nhảy  khoảng p50  khoảng max  dự báo mất/kill
mysql   =0 + sync_binlog=0                            3819      508       5.9ms       7.6ms               11
mysql   =0 + sync_binlog=0 + log_writer=OFF           2516        8     184.2ms     818.6ms              844
maria   flush_log_at_trx_commit=0                     2897        3    1001.7ms    1003.2ms             1363

mysql   =0 + sync_binlog=0                            2425      473       6.2ms      19.5ms                8
mysql   =0 + sync_binlog=0 + log_writer=OFF           2295        9     189.7ms     799.4ms              767
maria   flush_log_at_trx_commit=0                     2001        3    1002.6ms    1007.1ms              857
Số dự báo khớp vẫn chưa chứng minh được nguyên nhân. Muốn chắc thì phải đổi đúng một biến rồi kill thật:
| dự báo mất / lần kill | đo được / lần kill | |
|---|---|---|
| MySQL, bật luồng ghi | 8–11 | 6 / 5 = 1,2 (hai lượt, lượt nào cũng mất 6) |
MySQL, innodb_log_writer_threads=OFF | 767–844 | 2986 / 5 = 597, 3447 / 5 = 689 |
| MariaDB | 857–1363 | 9123 / 5 = 1825 |
Dòng đầu lệch: MySQL bật luồng ghi mất ít hơn dự báo khoảng 7 đến 9 lần, lệch về phía an toàn. Đầu dò có sàn 5 ms, nên khoảng cách đo được chỉ có thể dài bằng hoặc hơn thực tế, và dự báo chỉ có thể lệch lên. Hai dòng còn lại khớp dự báo về bậc độ lớn. Chỉ đổi một biến mà MySQL đi từ mất 6 commit lên mất 3.447: gấp 575 lần.
Diễn giải: ai gọi write()
innodb_flush_log_at_trx_commitquyết định commit chờ tới đâu, chứ không quyết định khi nào log được ghi.1chờ fsync,2chờwrite(),0không chờ gì cả.- MySQL 8 có các luồng ghi log riêng. Theo tài liệu của
innodb_log_writer_threads(mặc định bật), các luồng này chuyển redo từ log buffer sang OS. Trong các lượt đo ở đây, chúng hiện ra thành khoảng 6 ms một lần ghi, đúng bằng sàn của đầu dò. Ở=0, commit không chờ chúng, nhưng chúng chỉ chạy sau vài mili giây. Vì thế tiến trình chết thì gần như không mất gì. - MariaDB cư xử như thể không có luồng đó. Ở
=0, redo nằm chờ tới lần ghi định kỳ mỗi giây (innodb_flush_log_at_timeout=1). Bench in ra cấu hình lúc chạy:innodb_flush_method=O_DIRECT,innodb_log_file_buffering=OFFtrên bản 11.8.9 (kết quả). Vậy file redo đi thẳng xuống đĩa, không qua page cache:write()và xuống đĩa là cùng một lần, vàlsn_flushedmới là bộ đếm đúng trên MariaDB.
Còn vì sao bộ đếm của MariaDB lại đếm phần được sinh ra, tôi chưa đọc mã nguồn nên không trả lời được. Thứ duy nhất tôi đo được là nó tăng khít theo lsn_current.
Giới hạn của phép đo
- kill -9 chỉ kiểm được
write(), không kiểm được fsync. Bài này không đo gì về mất điện. - Bộ đếm của MySQL mới chỉ kiểm được một nửa. Trong lượt chạy lại bằng bench trên MySQL,
os_log_writtentăng 2.850.816 byte, trong khi LSN tăng 1.522.191, tức là nó không đếm LSN như trên MariaDB. Nhưng tôi chưa chứng minh được nó đếm đúng số byte đã ghi. Tôi vẫn dùng nó cho MySQL vì kết quả crash khớp dự báo, và đó đúng là kiểu tin đã hỏng một lần trên MariaDB. Trên MySQL, bộ đếm này còn nhảy nhiều hơn chính LSN (495 so với 289 lần trong một lượt bench, 497 so với 295 trong lượt khác), và tôi chưa giải thích được. - Mỗi server chỉ một phiên bản. Nghĩa của bộ đếm mới được xác nhận trên MariaDB 11.8.
- Mẫu nhỏ, máy nhiễu: năm lần kill mỗi chế độ, hai đến ba lượt, chạy trên WSL2, đầu dò có sàn 5 ms.
- Lượt crash của MariaDB chạy trước khi có đầu dò. Tốc độ commit của lượt đó không được ghi cùng bảng, nên phép so 1825 với 857–1363 chỉ có giá trị ở mức bậc độ lớn.
Đánh đổi (Trade-offs)
- Một chỉ số, mỗi server một câu truy vấn: hai server chung tên bộ đếm, chung gốc gác, mà bộ đếm đúng lại khác nhau. Câu truy vấn dashboard nào chép từ bên này sang bên kia cũng phải kiểm lại riêng.
lsn_flushedchỉ đúng khi cònO_DIRECT: bật lại bộ đệm cho file log thìwrite()và xuống đĩa tách thành hai lần. Tôi đoán lúc đó bộ đếm này sẽ phóng đại cửa sổ mất dữ liệu khi tiến trình chết, nhưng chưa thử.- Luồng ghi riêng về nguyên tắc không miễn phí: nó đổi lấy cửa sổ mất dữ liệu rất hẹp khi tiến trình chết. Chi phí CPU của nó tôi chưa đo. Khi tắt luồng ghi, tốc độ commit đi từ 4194 ở lượt đầu xuống 2516 ở lượt hai. Dao động đó còn lớn hơn chênh lệch giữa các chế độ, nên các bảng trên không trả lời được câu này.
Khi nào chuyện này đáng lo
- Đọc
flush_log_at_trx_commitlà “commit chờ tới đâu”. Mất bao nhiêu dữ liệu thật thì còn tùy kiến trúc bên dưới. - Hỏi riêng hai loại sự cố: tiến trình chết và mất điện. Bị OOM killer giết, hay container bị hệ thống điều phối giết, là loại thứ nhất. Ở loại này, với
=0, hai server chênh nhau nhiều bậc độ lớn. - Trước khi vẽ biểu đồ từ một bộ đếm trên server chưa kiểm, hãy lấy mẫu tay nó cạnh một bộ đếm mình đã hiểu. Lần này, ba dòng là đủ.
Tôi chọn bộ đo theo cái tên của nó, và chỉ biết nó đếm thứ khác vì một con số thứ hai tôi tự đo không thể cùng đúng với nó.